구글, AI 학습에 저작물 무단 사용했나…출판업계 집단소송 제기
기사 입력시간 : | 이현근 기자
AI요약
인공지능이 자동으로 줄인 ‘세줄 요약’ 기술을 사용합니다.
전체 내용을 이해하기 위해서는 기사 본문과 함께 읽어야 합니다.
결론
- 원고 측은 구글이 수백만 권의 저작물을 허가 없이 복제해 제미나이 AI 모델 학습에 활용했다고 주장하며, 구글이 확보한 디지털 도서를 저작권자의 동의 없이 AI 학습 용도로 전용했다고 강조했습니다.
- 또한, 원고들은 구글이 저작권자의 허가나 보상 없이 방대한 저작물을 활용한 것은 의도적인 저작권 침해에 해당한다고 주장하며, 손해배상과 함께 학습 데이터의 사용 중단 및 폐기를 법원에 요청했습니다.
- 이번 사건은 AI 기업과 콘텐츠 권리자 간 저작권 분쟁이 확대되는 가운데 제기되었으며, 소송 결과는 생성형 AI의 학습 데이터 활용 범위와 저작권 인정 기준에 중요한 선례가 될 것으로 전망됩니다.
- #구글
- #저작권
- #AI소송
- #제미나이
- #출판사

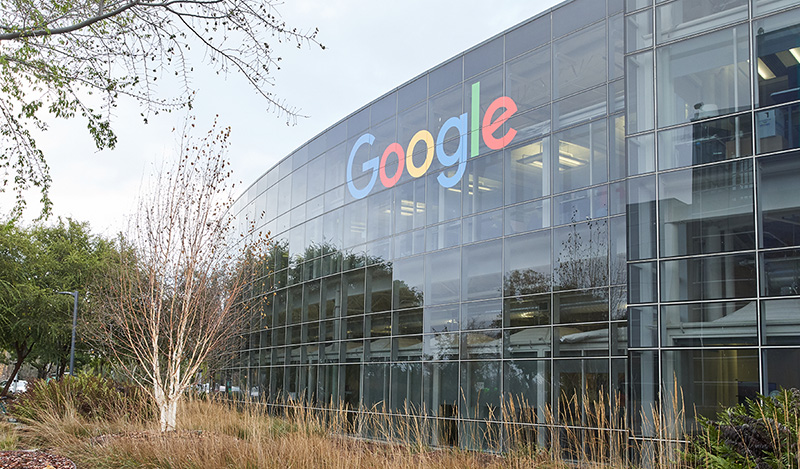
미국의 주요 출판사 세 곳과 유명 작가가 구글을 상대로 생성형 AI 모델 제미나이 개발 과정에서 저작권을 침해했다며 집단소송을 제기했다.
외신에 따르면 아셰트 북 그룹, 센게이지러닝, 엘스비어 등 출판사와 소설가 스콧 터로는 미국 뉴욕 연방법원에 구글을 상대로 집단소송을 제기했다. 원고 측은 구글이 수백만 권의 저작물을 허가 없이 복제해 제미나이 AI 모델 학습에 활용했다고 주장했다.
원고들은 구글이 당초 구글 북스와 구글 플레이북 서비스 운영을 위해 확보한 디지털 도서를 저작권자의 동의 없이 AI 학습 용도로 전용했으며, 이를 통해 상업적 이익을 얻었다고 주장했다. 또한 구글이 저작권자의 허가나 보상 없이 방대한 저작물을 활용한 것은 의도적인 저작권 침해에 해당한다고 강조했다.
이번 소송은 출판사와 작가들을 대표하는 집단소송 형태로 진행될 예정이다. 원고 측은 손해배상과 함께 저작권을 침해해 생성된 학습 데이터의 사용 중단 및 폐기를 법원에 요청했다.
이번 사건은 AI 기업과 콘텐츠 권리자 간 저작권 분쟁이 확대되는 가운데 제기됐다. 현재 오픈AI와 마이크로소프트, 메타, 앤트로픽 등 주요 AI 기업들도 저작물의 AI 학습 활용을 둘러싸고 언론사와 작가, 창작자들로부터 유사한 소송에 직면해 있다. 이번 소송 결과는 생성형 AI의 학습 데이터 활용 범위와 저작권 인정 기준에 중요한 선례가 될 것으로 전망된다.
이현근 기자 press@appstory.co.kr
국내 최초 스마트 & 앱매거진 - 앱스토리
Copyright © 앱스토리, 무단전재 및 재배포 금지